Un evento invisibile diventa un incidente scoperto troppo tardi.
Log separati su molti server rendono lenta la ricerca e complicano la ricostruzione di ciò che è successo.
Dashboard eventi dal vivo, log della flotta aggregati e ricercabili, e alert push self-hosted che arrivano sul telefono nel momento esatto in cui qualcosa succede. Il nucleo resta nella tua infrastruttura; l'invio email usa soltanto il server SMTP opzionale che configuri.
Log separati su molti server rendono lenta la ricerca e complicano la ricostruzione di ciò che è successo.
La dashboard offre una vista unica; gli alert push avvisano subito quando serve attenzione.
Filtri il caso, ricostruisci la sequenza e controlli da quale server è partito l'evento.
Dashboard eventi live
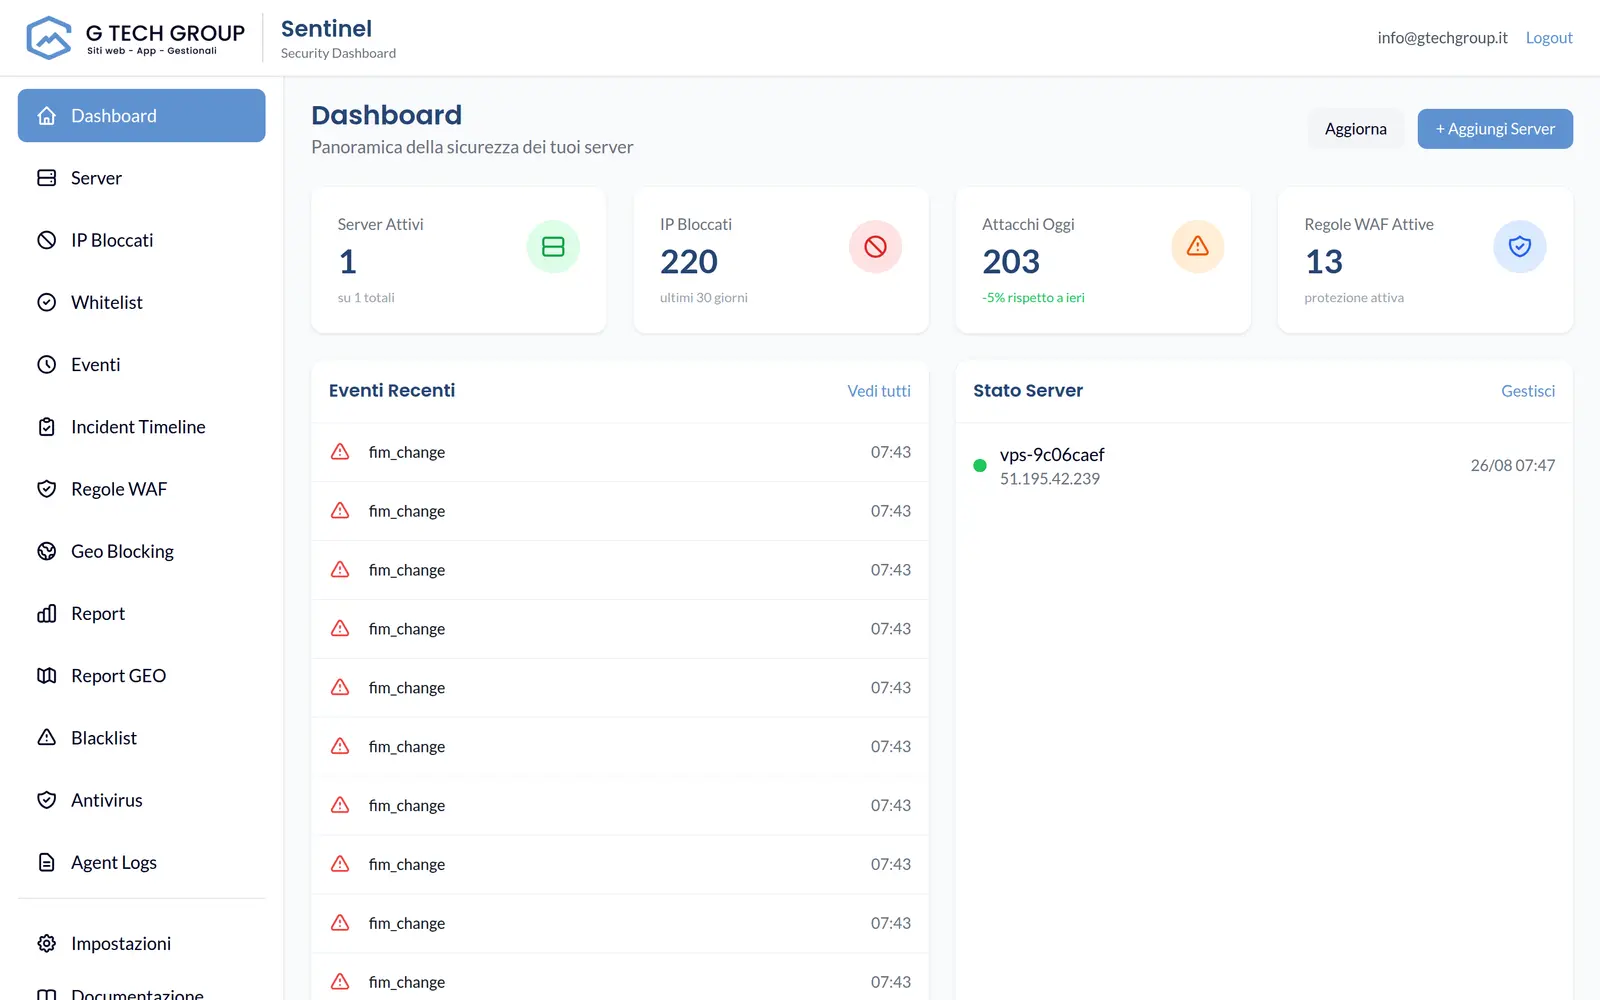
La dashboard si aggiorna da sola: gli eventi di tutta la flotta scorrono con un refresh automatico ogni pochi secondi, senza ricaricare la pagina. Vedi blocchi WAF, IP fermati, tentativi SSH e superamenti di soglia man mano che accadono.
Log della flotta aggregati
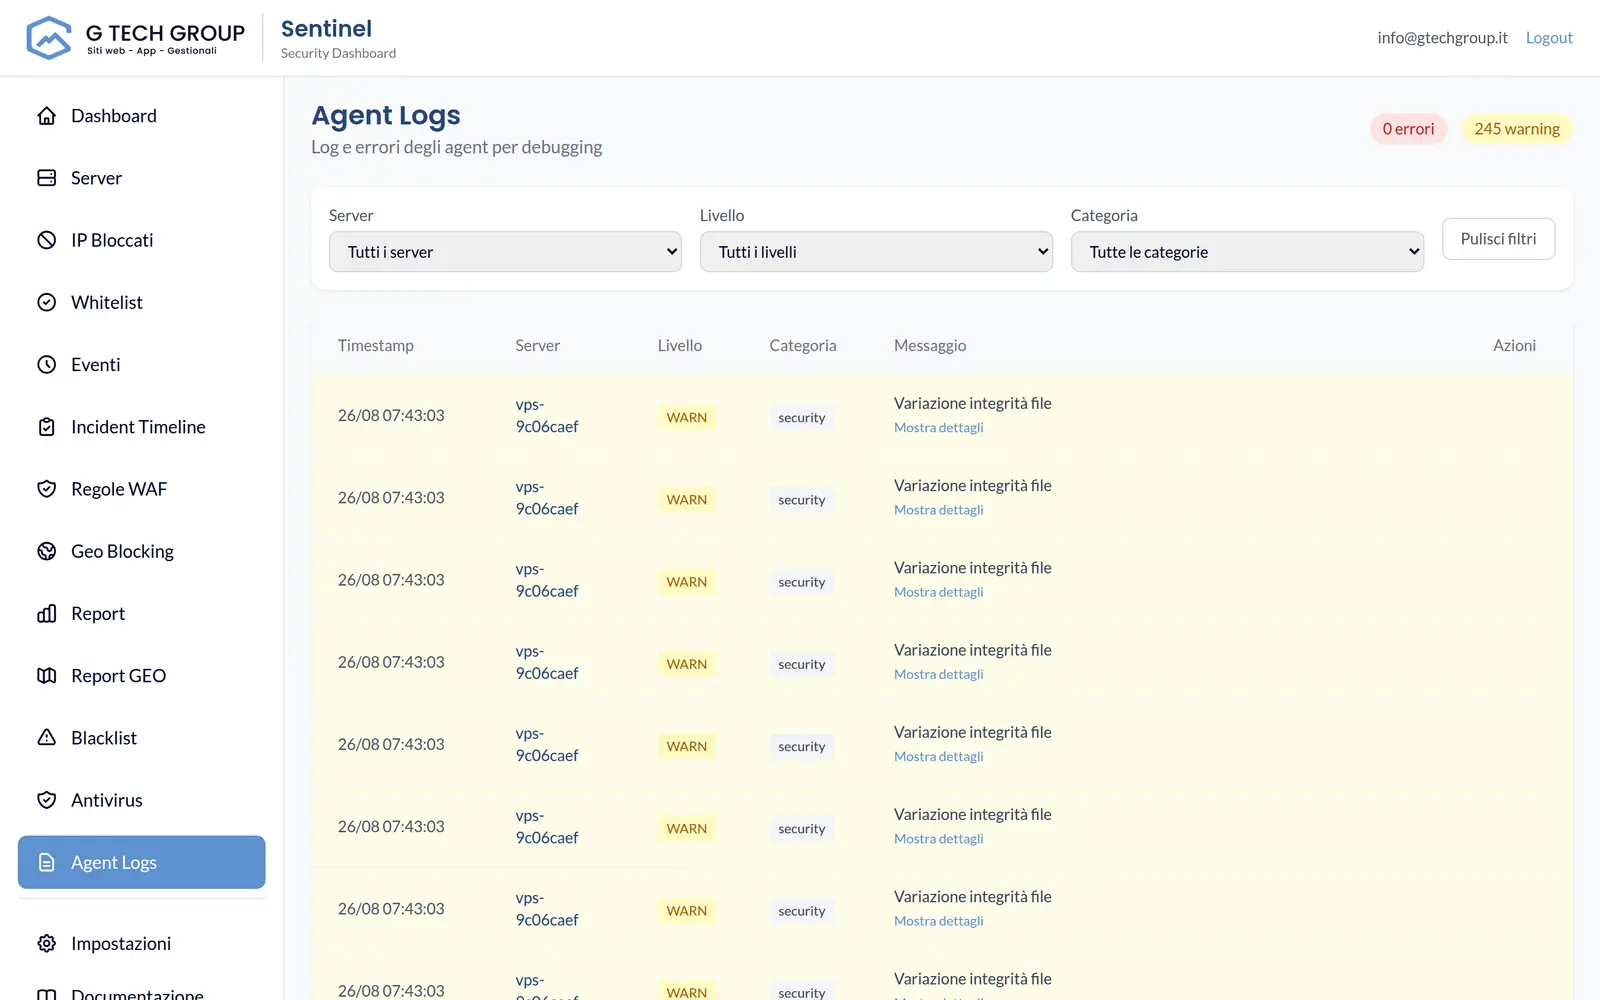
Ogni agent invia i propri log in batch via gRPC (SubmitLogs) verso il server centrale, che li raccoglie nella tabella agent_logs. Dalla pagina /logs filtri, conti e apri il dettaglio JSON di ogni riga, con anti-flood per-server per non annegare nel rumore.
Alert push ntfy + app Android
Il server genera una push ntfy self-hosted (topic + token, con priorità e tag) nel momento esatto in cui scatta un evento critico. È il canale davvero istantaneo: la dashboard si aggiorna da sola, ma è la push a suonare sul telefono. L'app G Tech per Android è un client ntfy che consulta anche le API.
Incident timeline, Report & Geo
Ricostruisci un incidente, analizza da 7 giorni a un anno ed esporta i dati. I riepiloghi periodici possono essere recapitati via ntfy e, quando configurato, anche via email.
Per ogni indirizzo apri la cronologia completa: eventi WAF, blocchi, tentativi e azioni intraprese, con geolocalizzazione, ISP e stato attuale del blocco.
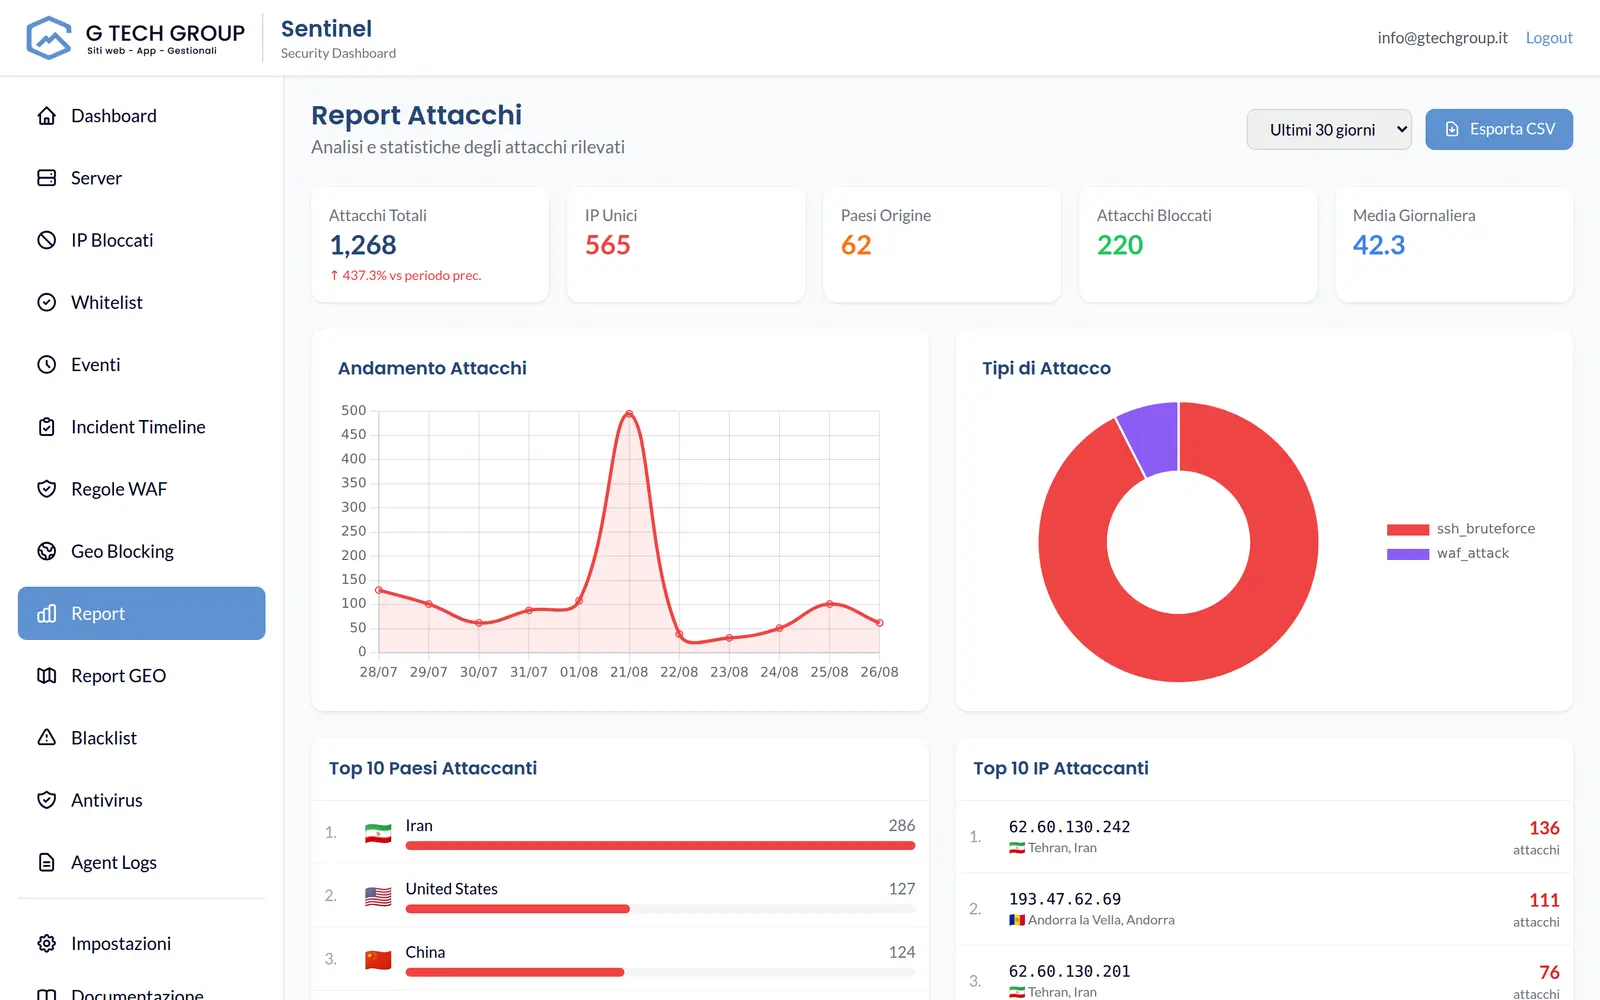
Scegli 7, 30, 90 o 365 giorni e confronta totale, media, tipi di attacco, top IP, paesi e provider. La timeline recente è filtrabile ed esportabile in CSV.
Visualizza paesi, città e ISP di provenienza, apri il dettaglio di un paese e distingui numero di attacchi e IP unici.
Ricevi una sintesi giornaliera o settimanale via ntfy; il server dispone anche di un report mailer SMTP per la consegna via email quando configurato.
Metriche & Prometheus
Sia il server sia gli agent espongono metriche in formato Prometheus 0.0.4. L'endpoint /metrics del server è in bind su 127.0.0.1 — non esposto pubblicamente — mentre ogni agent pubblica su :9100, pronto per essere scrapato dal tuo Prometheus.
Domande frequenti
No, ed è giusto essere onesti: la dashboard si aggiorna con un polling HTMX automatico ogni ~30 secondi, senza ricaricare la pagina. Il canale davvero istantaneo è la push ntfy, che il server genera nell'istante esatto dell'evento.
Gli alert push possono viaggiare su ntfy self-hosted, con server, topic e token tuoi. Se abiliti l'invio email, il messaggio passa invece dal server SMTP che hai configurato.
Gli eventi si filtrano per server e tipo (waf_block, ip_blocked, ssh_failed, rate_limit…). I log della flotta si filtrano per Server, Livello (error/warn/info) e Categoria (update/security/system/network), con contatori e dettaglio JSON.
Il server marca un agent offline solo dopo un debounce di ~90 secondi: micro-interruzioni di rete non generano falsi allarmi. Quando l'agent torna, ricevi la notifica di rientro online.
Sì, se il report mailer SMTP è configurato. In alternativa i riepiloghi giornalieri o settimanali arrivano via ntfy e nell'app Android. Il report completo resta sempre consultabile ed esportabile dal pannello.
Sì. Le metriche sono in formato 0.0.4: il server le espone su 127.0.0.1 (bind locale, non pubblico) e ogni agent su :9100, pronto per lo scraping dal tuo Prometheus.
Ti mostriamo la dashboard di Sentinel dal vivo sulla tua infrastruttura e configuriamo alert e report su misura.